OCR para resultados de laboratorio: guía de fidelidad clínica
El OCR sí puede extraer resultados de laboratorio automáticamente, pero solo cuando la extracción conserva valor, unidad, rango de referencia y flag juntos, y pasa por una validación antes de tocar la historia clínica. No sustituye el juicio médico ni la comparación con los valores del laboratorio emisor. La recomendación práctica es simple: úsalo dentro de un flujo con revisión humana y reglas automáticas de verificación, nunca como lectura final.
En resumen:
- El OCR en informes de laboratorio solo es confiable si mantiene la unidad, rango y flags, y pasa una validación previa antes de integrarlos en la historia clínica.
- Los errores más comunes incluyen confusión de dígitos, pérdida de unidades y flags, y documentos incompletos, que pueden llevar a decisiones clínicas incorrectas.
- La extracción debe preservar los resultados completos con prueba, valor, unidad, rango y flag, sin redondeos ni eliminaciones de operadores como “<” o “>” para evitar errores.
- La calidad del documento original afecta significativamente la precisión del OCR, siendo mayor en PDFs nativos y menor en notas manuscritas o fotos borrosas.
- Es fundamental validar cada formato de laboratorio y realizar revisión humana en casos de resultados fuera del rango o marcados con notas manuscritas para garantizar seguridad clínica.
Tabla de contenidos
- Qué es el OCR en informes de laboratorio y por qué son documentos especiales
- Errores habituales de OCR en resultados clínicos y sus consecuencias
- Buenas prácticas para extraer datos de laboratorio con fidelidad clínica
- Flujo operativo recomendado: de la imagen o PDF a la historia clínica
- Qué exigir a una solución de OCR para laboratorios (criterios técnicos)
- Qué ofrece Nexolab para digitalizar resultados de laboratorio
- Cómo adoptar el OCR sin comprometer la seguridad clínica
- Prueba Nexolab con tus primeros informes de laboratorio
- Fuentes
- Preguntas frecuentes
Qué es el OCR en informes de laboratorio y por qué son documentos especiales
El OCR tradicional reconoce caracteres, no significado: convierte una imagen en texto plano carácter por carácter, sin entender que “12.5” pertenece a la fila de glucosa ni que el asterisco junto al número es una alerta clínica. Los modelos más recientes de visión y lenguaje (conocidos como VLM) leen la página completa como un humano lo haría, relacionando cada valor con su etiqueta, su unidad y su rango en un solo paso. Esa diferencia importa porque un informe de laboratorio no es un párrafo de texto: es una tabla con dependencias entre columnas.
La heterogeneidad de formatos complica todo. Un PDF nativo generado por el sistema del laboratorio se lee con precisión casi perfecta. Una foto tomada con el móvil, un fax borroso o un escaneo torcido pueden degradar la calidad y reducir la precisión del reconocimiento.
En análisis clínicos, cada símbolo pesa. Los decimales cambian el significado (1.2 no es 12), los operadores como < o > indican límites de detección del ensayo, y los flags (H, L, o marcas de valor crítico) son la señal que dispara una llamada urgente al paciente. Perder cualquiera de estos elementos durante la extracción no es un detalle estético: es un error clínico potencial.
- OCR clásico: rápido, económico, pero ciego al contexto de la tabla.
- IA semántica (VLM): lee unidades y flags juntos, reduciendo la fragmentación típica del reconocimiento carácter por carácter.
- Ambos enfoques requieren validación posterior, aunque en distinta medida.
Errores habituales de OCR en resultados clínicos y sus consecuencias
Los fallos más frecuentes en la extracción automática de laboratorios se agrupan en unas pocas categorías, pero cada una puede alterar una decisión médica.
- Confusión de dígitos y puntuación decimal. El motor lee “8” donde había “3”, o convierte una coma en punto y desplaza el valor un orden de magnitud.
- Pérdida o transformación de unidades y rangos. Un valor de colesterol en mg/dL puede quedar sin unidad visible, dejando el número sin contexto clínico.
- Flags mal interpretados o eliminados. Un asterisco junto a un valor crítico desaparece durante la limpieza automática del texto, y el resultado se archiva como normal.
- Documentos incompletos, páginas recortadas o duplicadas. Un informe de tres páginas se procesa como una sola, y los datos de la segunda hoja simplemente no llegan al sistema.
- Manuscritos y anotaciones a mano. Comentarios del bioquímico o correcciones manuales sobre el impreso son el punto más débil de cualquier extracción automática.
Consejo profesional: revisa siempre los resultados marcados con asterisco, nota manuscrita o valor inesperado antes de cerrar el expediente: la validación humana en estos casos es obligatoria, incluso cuando el sistema no marcó ningún error.
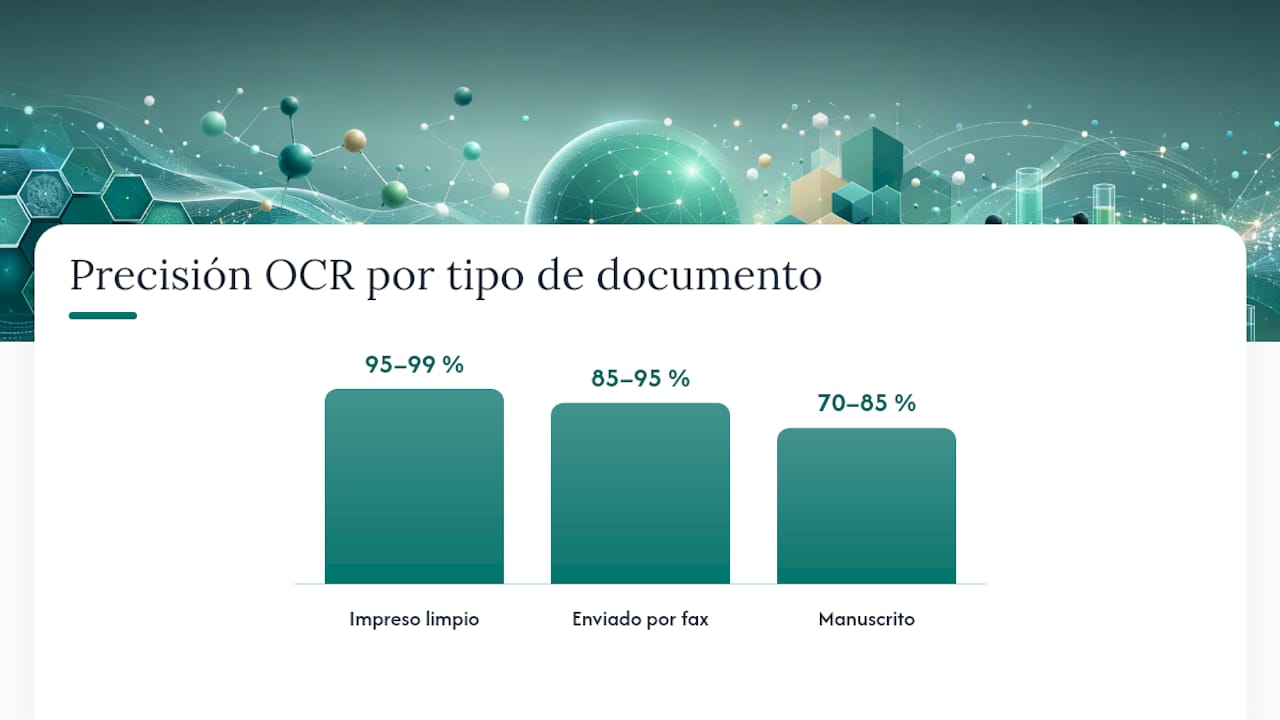
La calidad del documento de origen determina directamente cuánto puedes confiar en la máquina. En pruebas controladas, la precisión por campo llega al 95 y 99 % en documentos impresos limpios, cae al 85-95 % en documentos enviados por fax, y baja hasta el 70-85 % en textos manuscritos. Esa brecha de casi 30 puntos entre un PDF nativo y una nota escrita a mano es la razón por la que ningún flujo serio puede tratar todos los documentos igual.
Buenas prácticas para extraer datos de laboratorio con fidelidad clínica
La regla de oro es extraer la unidad clínica completa, nunca el número aislado. Cada resultado debe salir del proceso con cinco campos amarrados entre sí: nombre de la prueba, valor, unidad, rango de referencia y flag. Separar el número de su contexto es la forma más común de generar un dato inútil, o peor, engañoso.
No redondees nada. Un sistema que convierte “4.35” en “4.4” está alterando un dato clínico, y en pruebas con rangos estrechos (hormonas, electrolitos) ese redondeo puede mover un resultado de normal a alterado. Los operadores como <0.1 o >1000 también deben preservarse literalmente: son información sobre el límite del método de laboratorio, no ruido a limpiar.
Las validaciones automáticas por rango detectan buena parte de los errores antes de que lleguen a un humano: si un valor extraído está fuera del rango biológicamente posible para esa prueba, el sistema debe marcarlo para revisión en lugar de aceptarlo. Complementa esto con un muestreo humano inicial sobre cada formato nuevo de laboratorio. La validación del primer lote por cada plantilla de informe es la mejor forma de calibrar reglas antes de escalar el volumen.
Los resultados manuscritos merecen su propio carril: márcalos explícitamente como “pendiente de revisión manual” en lugar de dejarlos mezclados con los datos ya verificados. Y todo cambio hecho sobre un dato extraído (una corrección de unidad, un ajuste de rango) debe quedar auditado con fecha, usuario y motivo.
- Extrae siempre: prueba + valor + unidad + rango + flag, como bloque único.
- Nunca redondees decimales ni elimines operadores de comparación.
- Aplica reglas de rango biológico como primer filtro automático.
- Separa visualmente los resultados manuscritos del resto.
- Registra cada corrección manual en un historial auditable.
Recuerda que la interpretación final siempre depende del rango del laboratorio emisor, no de un valor genérico. Un resultado fuera de rango no es diagnóstico por sí mismo; depende de la edad, el sexo, el estado del paciente y el método analítico de ese laboratorio en particular, como recuerda la guía de interpretación clínica de la Universitat de Barcelona.
Flujo operativo recomendado: de la imagen o PDF a la historia clínica
Un flujo de extracción bien diseñado tiene cinco pasos claros, y saltarse cualquiera de ellos es donde suelen aparecer los errores más costosos.
- Preparación del documento. Escanea en resolución suficiente (mínimo 300 DPI para texto pequeño) y corrige inclinación y sombras antes de procesar; una foto mal encuadrada arruina la extracción incluso con el mejor motor disponible.
- Extracción. Define de antemano los campos que esperas (nombre, valor, unidad, rango, flag) y usa anclaje de biomarcadores: el sistema busca primero coincidencias exactas de nombres de pruebas conocidas antes de dejar que un modelo de lenguaje interprete el resto. Esta técnica de anclaje previo al modelo limita el vocabulario disponible y evita que el sistema invente resultados que no existen en el documento original. La salida ideal es estructurada, en JSON o en formato FHIR.
- Verificación. Aplica un checklist humano fijo: comprobar decimales, unidades, flags y coincidencia con el rango del laboratorio emisor. Complementa con muestreo estadístico sobre un porcentaje del lote, no solo sobre los casos marcados como dudosos.
- Integración. Mapea cada resultado a un código estandarizado (LOINC u otro catálogo local) y asócialo siempre a paciente y fecha exacta de la muestra, nunca solo a la fecha de carga del documento.
- Auditoría. Mantén un registro de cada cambio hecho sobre los datos extraídos, con trazabilidad completa de quién corrigió qué y por qué.
Este orden no es burocracia innecesaria. Sistemas prototipo que integran extracción y estructuración han mostrado reducciones significativas del tiempo de procesamiento en pruebas controladas, pasando de varios minutos a pocos segundos frente al método manual en pruebas controladas, una ganancia que solo tiene sentido si la verificación posterior sigue siendo rigurosa.
Qué exigir a una solución de OCR para laboratorios (criterios técnicos)
Antes de adoptar cualquier herramienta, evalúala con criterios técnicos, no con promesas de marketing. La lista siguiente sirve tanto para auditar un proveedor externo como para configurar un sistema propio.
- Preservación de precisión numérica y flags: comprueba que el sistema no redondea decimales ni descarta asteriscos o marcas de alerta durante la limpieza del texto.
- Robustez ante baja calidad de imagen: pide ejemplos de precisión con documentos de fax o fotos con mal encuadre, no solo con PDFs perfectos.
- Definición de columnas semánticas y exportación estructurada: la herramienta debe permitir configurar qué campos esperas (prueba, valor, unidad, rango, flag) y exportarlos en JSON o FHIR, listos para integrarse en otro sistema.
- Interfaces o API para conectar con tu historia clínica electrónica o sistema de laboratorio (LIS): sin esto, cada extracción exige copiar y pegar manualmente.
- Seguridad y cumplimiento en el manejo de datos de salud: cifrado de archivos, control de acceso por profesional y políticas claras de retención de datos.
Qué ofrece Nexolab para digitalizar resultados de laboratorio
Nexolab incorpora OCR integrado dentro de un espacio privado por médico, así que la extracción de documentos convive con el resto del expediente sin mezclarse entre distintos profesionales. El almacenamiento de archivos (PDFs, fotos, recetas, informes de laboratorio) y la búsqueda rápida por nombre o cédula resuelven el problema cotidiano de encontrar un resultado antiguo en segundos, no en carpetas físicas.
- OCR integrado para extraer texto de documentos de laboratorio y otros informes médicos.
- Almacenamiento seguro de archivos asociados a cada paciente, dentro de un espacio 100 % privado por médico.
- Búsqueda rápida por nombre o número de cédula, útil cuando necesitas retomar un caso con historial extenso.
- Plan gratuito para hasta 5 pacientes, y planes Pro (mensual o anual) para consultorios con volumen ilimitado.
Una forma práctica de empezar es pilotar con 10 o 20 informes de un mismo laboratorio, revisar manualmente cada campo extraído y ajustar el proceso antes de escalarlo a todo el consultorio.
Cómo adoptar el OCR sin comprometer la seguridad clínica
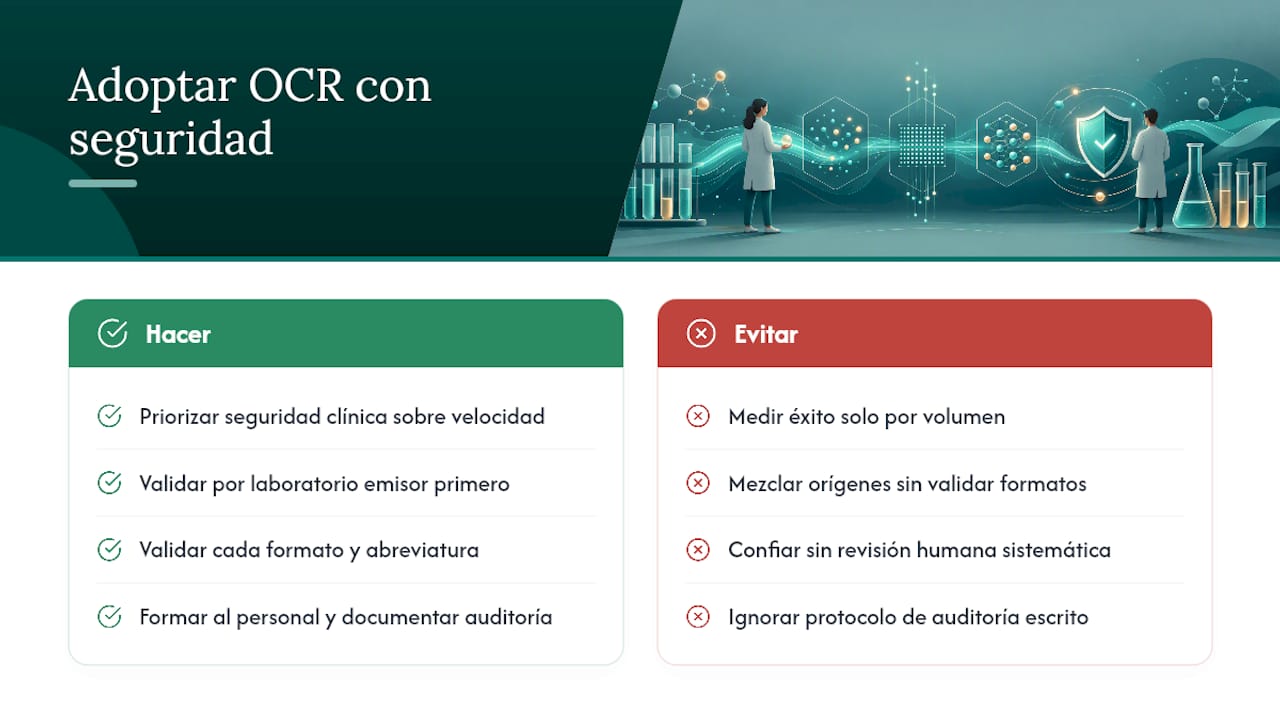
La tentación con cualquier herramienta de OCR es medir su éxito por velocidad. Es el criterio equivocado. Un sistema que extrae 500 informes por hora con un 8 % de errores en flags críticos es peor que uno que procesa 50 por hora con revisión humana sistemática, porque el coste de un error clínico no se compensa con volumen.
Lo que de verdad diferencia una implementación segura de una arriesgada es empezar por laboratorio emisor, no por volumen total. Cada laboratorio tiene su propia plantilla, sus propias abreviaturas y su propio formato de flags. Validar formato por formato, antes de mezclar todos los orígenes en un mismo flujo, es lo que separa un piloto bien hecho de un despliegue improvisado. La formación del personal en qué revisar, y un protocolo de auditoría que quede por escrito, importan tanto como el motor de OCR que elijas.
— MadScientist
Prueba Nexolab con tus primeros informes de laboratorio
Nexolab es la alternativa a mantener carpetas físicas o hojas de cálculo sueltas para tus resultados de laboratorio: un espacio privado por médico donde el OCR, el almacenamiento y la búsqueda de pacientes funcionan juntos desde el primer día. Puedes registrar hasta 5 pacientes sin coste y probar el flujo completo con 1 o 2 informes reales antes de decidir nada.
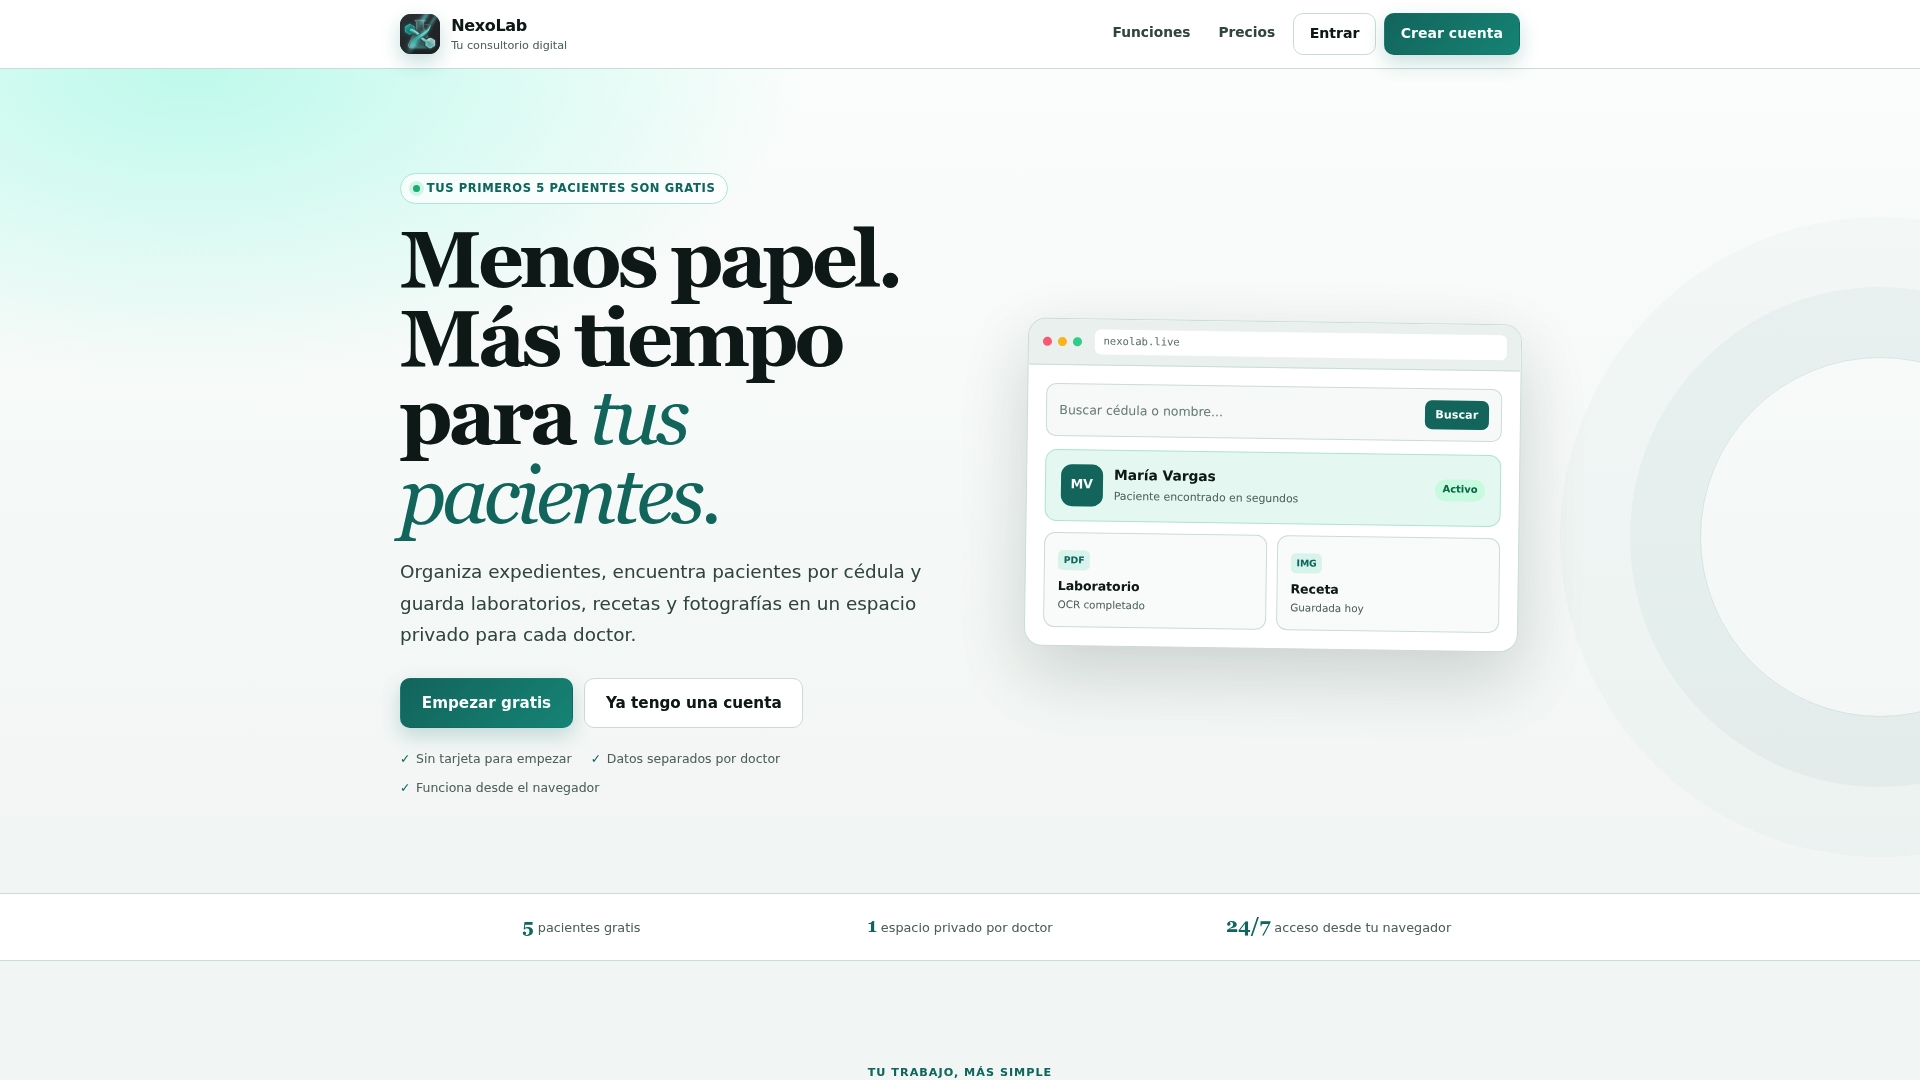
La forma más honesta de evaluar cualquier herramienta de OCR clínico es con tus propios documentos, no con una demostración genérica. Sube un informe limpio y otro con mala calidad de escaneo, compara los campos extraídos contra el original y ajusta tus reglas de verificación antes de mover un lote grande. Si trabajas también con expedientes completos, la gestión de historia clínica electrónica te muestra cómo se integra ese resultado con el resto del seguimiento del paciente. Para consultorios que quieran manejar volumen ilimitado desde el inicio, consulta los precios actuales en la página de Nexolab. Regístrate gratis en Nexolab y empieza tu propia prueba con los informes que ya tienes archivados.
Fuentes
- MedlinePlus: Cómo entender sus resultados de pruebas de laboratorio
- Imagetotable
- Revista E&S: Extracción e integración estructurada de resultados en PDF usando IA
- GitHub: fhir-brasil OCR utils
Preguntas frecuentes
¿Qué significan las siglas OCR?
OCR son las siglas de reconocimiento óptico de caracteres (optical character recognition), la tecnología que convierte una imagen de texto en texto digital editable. En informes de laboratorio, esa conversión debe ir acompañada de estructura (valor, unidad, rango, flag) para tener utilidad clínica real.
¿Qué es el OCR aplicado a resultados de laboratorio?
Es el proceso de extraer automáticamente los datos de un informe clínico (nombre de prueba, valor, unidad y rango) a partir de un PDF, foto o escaneo. La extracción estructurada preserva el contexto clínico mucho mejor que copiar solo el texto plano.
¿Cuál es la mejor herramienta de OCR gratuita para empezar?
No existe una única herramienta “mejor” válida para todos los casos: depende del formato de tus documentos y de si necesitas integración con tu historia clínica. Nexolab ofrece OCR integrado dentro de su plan gratuito para hasta 5 pacientes, útil para probar el flujo antes de decidir si necesitas manejar volumen ilimitado.
¿Cómo se escanea un documento correctamente para OCR?
Escanea en buena resolución, con luz uniforme y sin inclinación, evitando sombras sobre el texto. Cuando uses el móvil, encuadra la hoja completa y revisa que ningún borde quede recortado antes de subir la imagen.
¿Puede el OCR interpretar resultados escritos a mano?
Con mucha más dificultad que el texto impreso: la precisión en manuscritos cae a un rango de 70 a 85 % por campo, frente al 95-99 % de un documento impreso limpio. Cualquier anotación manuscrita en un informe de laboratorio debe marcarse siempre para revisión manual antes de integrarse al expediente.