
OCR para recetas: cómo digitalizar y estructurar datos clínicos
Sí: un OCR entrenado puede convertir una foto o escaneo de una receta en texto editable, y las implementaciones más avanzadas extraen campos como medicamento, dosis y posología, exportándolos en formatos como JSON. Aceptan entradas en JPG, PNG o PDF, pero la verificación de un profesional sigue siendo obligatoria antes de incorporar esos datos a una historia clínica, y estándares como FHIR facilitan que la información se comparta entre sistemas.
En resumen:
- Para reutilizar los datos clínicos, separa dosis, frecuencia y duración, y conviértelos en campos codificados compatibles con FHIR, no en un bloque de texto libre.
- Las recetas impresas suelen reconocerse mejor que las manuscritas; fotografía el documento en JPG, PNG o PDF, con luz uniforme y sin reflejos.
- Antes de guardar una receta en la historia clínica, exige validación profesional, conserva la imagen original y registra las correcciones para auditar cada cambio.
- Protege los datos con cifrado durante el envío y el almacenamiento, controles de acceso y espacios separados para la información de cada médico.
- Empieza con una prueba limitada y mide búsquedas, campos estructurados y revisiones clínicas; el OCR ayuda a archivar, pero no debe decidir tratamientos.
Tabla de contenidos
- Cómo funciona el OCR aplicado a recetas médicas
- Qué campos extrae un OCR para recetas y cómo organizarlos
- Formatos e imagen: impreso frente a manuscrito
- Integrar el OCR con sistemas clínicos mediante FHIR
- Buenas prácticas al capturar recetas en el consultorio
- Privacidad, seguridad y el papel de la verificación humana
- Lo que respalda adoptar OCR con controles adecuados
- Cuándo conviene incorporar OCR en tu consultorio
- Una plataforma que une OCR y gestión de pacientes
- Preguntas frecuentes
- Fuentes
Cómo funciona el OCR aplicado a recetas médicas
El proceso completo suele incluir varias etapas. Primero, la captura: una foto con el móvil o un escaneo de la receta en papel. Después viene el preprocesamiento, donde el sistema corrige la inclinación de la imagen, limpia el ruido visual y ajusta el contraste para que el texto resalte sobre el fondo.
La tercera etapa es el reconocimiento de caracteres propiamente dicho, donde el motor compara patrones visuales con su modelo entrenado para identificar letras, números y símbolos. Aquí está la diferencia entre un OCR genérico y uno pensado para recetas: los sistemas entrenados específicamente para formularios médicos usan redes neuronales ajustadas a plantillas típicas (membrete, espacios para dosis, firma) y reconocen abreviaturas farmacéuticas que un OCR genérico suele interpretar mal.
La última etapa es el postprocesamiento, donde el texto bruto se organiza en campos con nombre. La salida más simple es texto plano, útil para archivar o buscar por palabra clave. Las herramientas de extracción de texto de documentos médicos más avanzadas entregan además un objeto JSON con cada dato ya etiquetado, lo que permite llevarlo directamente a un sistema de gestión de pacientes sin reescribirlo a mano.

Qué campos extrae un OCR para recetas y cómo organizarlos
Una receta bien estructurada puede aportar campos como: paciente, prescriptor, fecha, medicamento, dosis, forma farmacéutica, posología, duración del tratamiento y observaciones. El reto no es solo detectar estos datos, sino separarlos correctamente cuando vienen escritos como una instrucción libre.
Por ejemplo, un texto como «1 comprimido cada 12 horas durante 7 días» debe dividirse en subcampos: dosis (1 comprimido), frecuencia (cada 12 horas) y duración (7 días). Un material didáctico sobre lectura de recetas señala precisamente esta necesidad de identificar partes del texto y procesar instrucciones por separado, en vez de tratarlas como un bloque único.
Una vez separados estos subcampos, conviene mapearlos a códigos clínicos reconocidos siempre que sea posible, en lugar de dejarlos como texto libre. Esto es lo que convierte una receta digitalizada en un dato realmente reutilizable dentro de una historia clínica electrónica, y no solo en una imagen con texto debajo.

Formatos e imagen: impreso frente a manuscrito
Los formatos más habituales que acepta un OCR para recetas son JPG, PNG y PDF, y casi cualquier cámara de móvil actual produce resolución suficiente si se usan bien. La recomendación práctica es encuadrar solo la receta, evitar que la foto quede inclinada y usar luz uniforme sin reflejos directos sobre el papel.
Lo que más perjudica la legibilidad son las sombras parciales, la rotación excesiva, la baja resolución al recortar demasiado la imagen, los reflejos de flash sobre papel satinado y las manchas de tinta o humedad. Con texto impreso, un OCR bien entrenado suele acertar la mayoría de los caracteres cuando la imagen cumple estas condiciones.
Con manuscritos la precisión baja de forma notable, sobre todo en abreviaturas médicas y cifras de dosis escritas a mano rápido. En estos casos, la verificación humana no es opcional: es un paso obligatorio antes de usar el dato para cualquier decisión clínica.
Integrar el OCR con sistemas clínicos mediante FHIR
Una vez extraídos los campos, el siguiente paso es darles una forma que otros sistemas puedan leer sin ambigüedad. Aquí entra el estándar FHIR, un modelo de intercambio de información clínica ampliamente adoptado. Su recurso MedicationRequest define cómo representar una prescripción como un objeto estructurado que incluye medicamento, dosis e instrucciones, permitiendo que distintos sistemas busquen y recuperen esa prescripción sin interpretarla de nuevo cada vez.
El flujo técnico recomendado sigue esta secuencia:
- La imagen pasa por el motor OCR y genera texto con campos candidatos.
- Un proceso de mapeo convierte esos campos en la estructura que exige MedicationRequest.
- El sistema genera un objeto JSON válido según el estándar FHIR.
- Ese objeto se envía al historial clínico electrónico mediante una API o se sincroniza en lotes programados.
Para consultorios que ya usan un sistema de gestión, las opciones de integración más comunes son una API REST, un SDK que se conecta desde la app propia, o simplemente la exportación periódica de archivos JSON que otro proceso importa después. Cualquiera de las tres rutas evita que alguien transcriba manualmente lo que el OCR ya extrajo.
Buenas prácticas al capturar recetas en el consultorio
La calidad del resultado depende tanto del software como de cómo se captura la imagen. Estos pasos mejoran la tasa de acierto de forma inmediata:
- Limpiar la superficie de la receta y aplanarla antes de fotografiar o escanear.
- Encuadrar solo el documento, dejando un margen pequeño sin recortar texto.
- Usar luz uniforme, evitando sombras propias y reflejos directos de flash.
- Mantener la cámara paralela al papel para evitar distorsión de perspectiva.
- Elegir un fondo neutro y de color contrastante con el papel.
Además de la captura, conviene establecer controles operativos: que un profesional revise el resultado antes de guardarlo como definitivo, conservar siempre la imagen original junto al texto extraído, y registrar cualquier corrección manual para poder auditar el proceso después.
Consejo profesional: nombra cada archivo con la fecha y el identificador del paciente antes de subirlo; así evitas confundir recetas similares cuando el volumen de documentos crece.
Privacidad, seguridad y el papel de la verificación humana
Digitalizar recetas implica manejar datos de salud, así que el cifrado en tránsito y en reposo, junto con controles de acceso que separen la información entre profesionales, son medidas mínimas y no opcionales. Cada médico debería tener su propio espacio de datos, sin mezcla con el de otros colegas del mismo consultorio o red.
En el plano operativo, ningún dato extraído por OCR debería incorporarse a una historia clínica sin que un profesional lo valide primero. La monografía de la OMS sobre seguridad de la medicación recomienda precisamente sistemas informatizados combinados con revisión de medicación como parte de un enfoque sistémico para reducir errores, no como un sustituto de esa revisión.
Lo que respalda adoptar OCR con controles adecuados
La misma monografía de la OMS sobre errores de medicación sitúa los sistemas informatizados junto a la revisión humana como palancas para reducir fallos, nunca como reemplazo de esa revisión. Estructurar los datos con un estándar como FHIR aporta algo que el texto plano no da: permite buscar, cruzar y reutilizar la información entre sistemas sin reinterpretarla cada vez.
Cuándo conviene incorporar OCR en tu consultorio
Mi postura es que el OCR rinde más como herramienta de archivado y búsqueda que como mecanismo de automatización clínica, y quien lo adopta esperando que decida por el profesional parte de una expectativa equivocada. El valor real aparece cuando reduce el tiempo que alguien pasa buscando una receta antigua, no cuando intenta sustituir el criterio médico.
Para medir si funciona, sigue tres indicadores: tiempo de búsqueda de documentos, proporción de recetas que terminan con campos estructurados en vez de solo texto, y cumplimiento real de la verificación clínica antes de guardar cada registro. Empieza con un piloto acotado, valida resultados y despliega después.
— MadScientist
Una plataforma que une OCR y gestión de pacientes
Si administras un consultorio, no hace falta montar esta cadena técnica por tu cuenta. En NexoLab ofrecemos un espacio privado por cada médico, con OCR integrado para leer recetas y otros documentos, almacenamiento organizado y un buscador rápido por nombre o cédula.
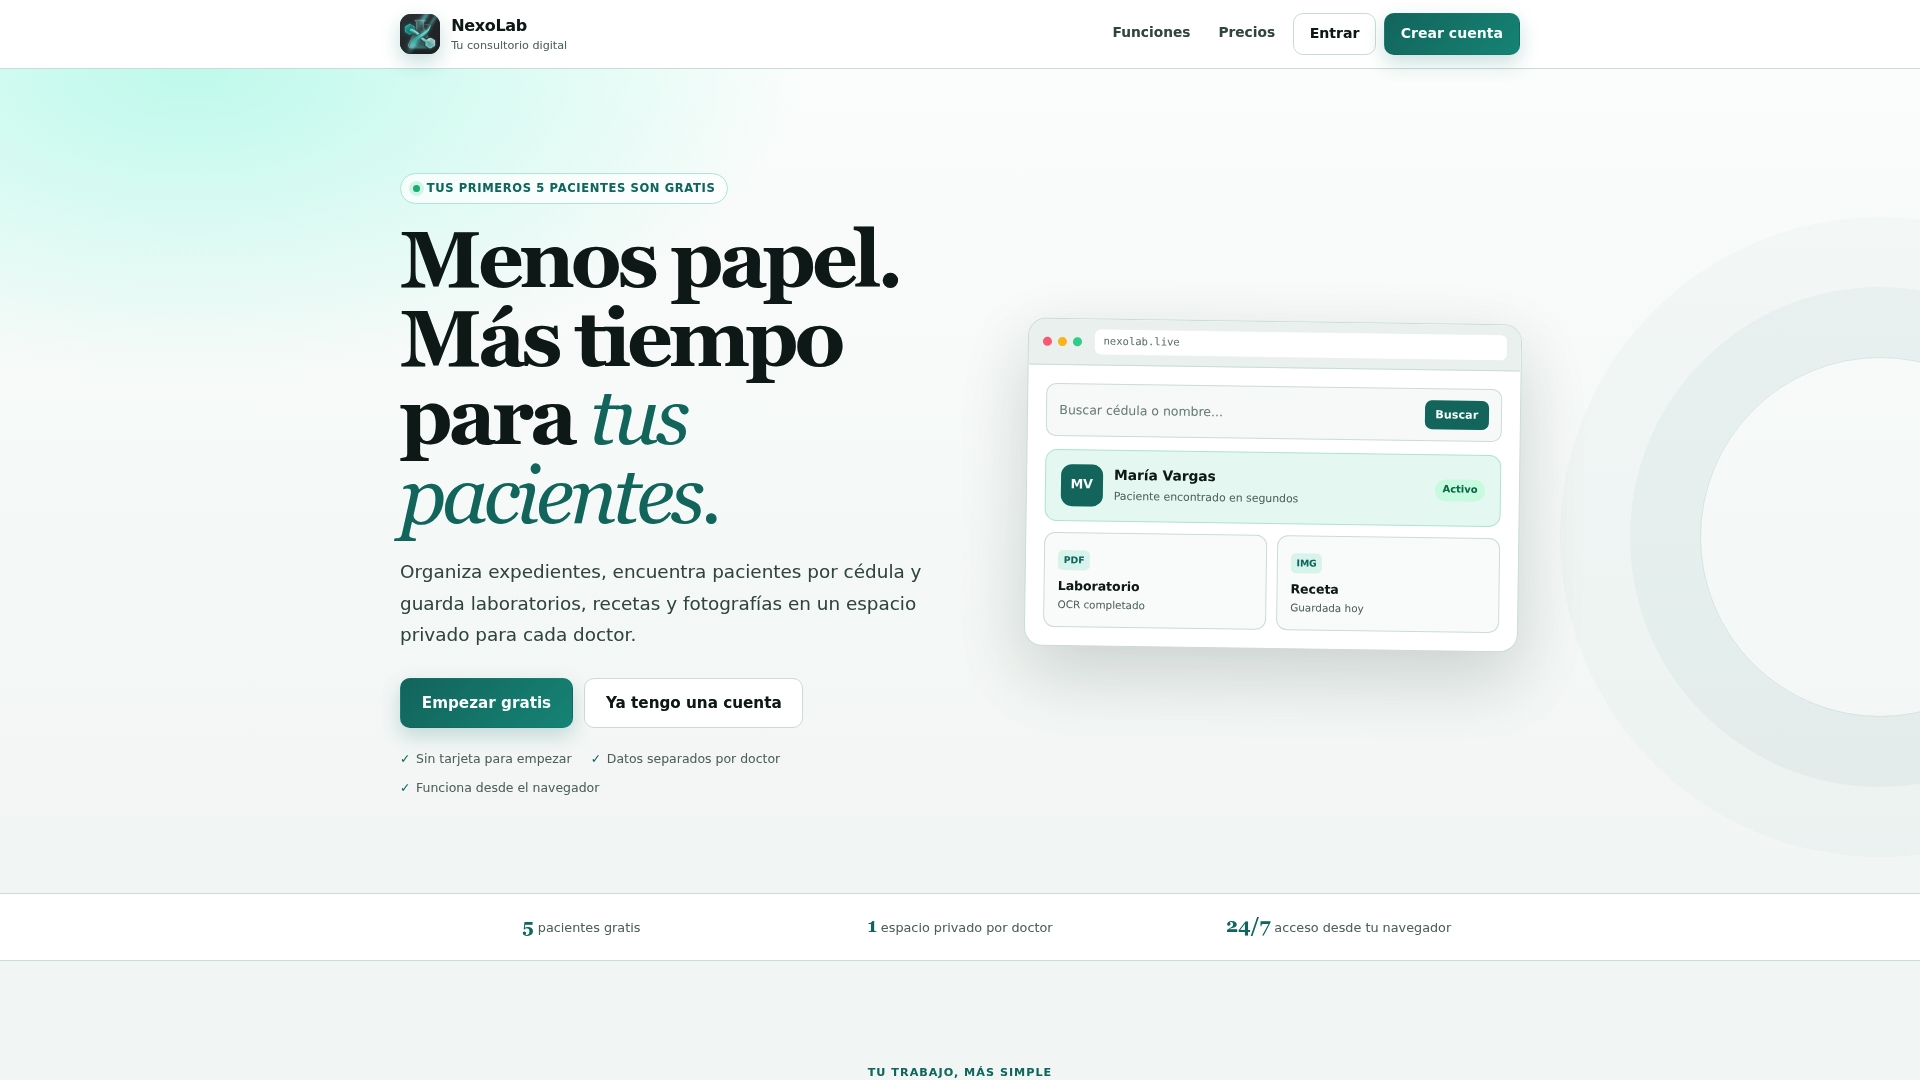
Puedes empezar con el plan Free, que incluye hasta cinco pacientes sin costo, y pasar al plan Pro mensual o Pro anual cuando tu consultorio crezca. Entra a Nexolab para crear tu espacio y probarlo con tus propias recetas.
Preguntas frecuentes
¿Cuál es el mejor OCR gratuito para digitalizar documentos?
No existe un único OCR gratuito superior para todos los casos: la elección depende de si necesitas solo texto plano o campos estructurados como dosis y posología. Para uso clínico, conviene priorizar una herramienta que permita revisión manual antes de guardar el resultado, en vez de fijarse solo en el precio.
¿Qué aplicación puedo usar para descifrar recetas médicas manuscritas?
Las aplicaciones de OCR entrenadas en formularios médicos funcionan mejor con manuscritos que un OCR genérico, aunque la precisión baja frente al texto impreso. En cualquier caso, un profesional de salud debe confirmar la lectura antes de usarla para una decisión clínica.
¿Qué papel juega la inteligencia artificial al generar o leer recetas médicas?
La inteligencia artificial puede ayudar a reconocer texto y sugerir campos como medicamento o dosis a partir de una imagen, pero no sustituye la decisión de prescripción, que corresponde siempre al profesional habilitado. Su función útil es acelerar la digitalización y reducir trabajo manual de transcripción.
¿Existe un escáner que pueda leer recetas médicas automáticamente?
Un escáner convencional no lee el contenido por sí solo: necesita un software OCR que procese la imagen capturada y extraiga el texto. Plataformas como NexoLab incorporan esa lectura OCR junto con el almacenamiento del documento, para que no haga falta usar dos herramientas separadas.
¿Cómo mejora la precisión del OCR la calidad de la imagen de una receta?
Una imagen bien iluminada, sin sombras ni reflejos y encuadrada correctamente mejora de forma notable la tasa de acierto del reconocimiento de texto. Los documentos impresos y planos, fotografiados en paralelo a la cámara, dan los mejores resultados frente a recetas arrugadas o manuscritas.