
Cómo extraer texto de PDF médicos sin perder el control clínico
Extraer texto de un PDF médico significa convertir informes, recetas y anexos escaneados en contenido buscable dentro de la ficha del paciente, sin sustituir el documento original. El sistema conserva el PDF como fuente legal, indexa el texto según metadatos como paciente, fecha y tipo de documento, y aplica controles de acceso para proteger la confidencialidad. El resultado práctico es un consultorio donde buscar un antecedente o un valor de laboratorio toma segundos en vez de minutos.
En resumen:
- La digitalización de PDFs médicos requiere registrar metadatos esenciales como identificación del paciente, tipo de documento, fechas, autor y encuentro clínico para cumplir con requisitos legales y de calidad.
- La extracción de texto mediante OCR debe realizarse en un flujo controlado que incluya revisión humana, indexación precisa y vínculo directo al PDF original para garantizar fiabilidad.
- Es imprescindible cifrar y gestionar cuidadosamente quién accede a los expedientes digitales, mantener registros de auditoría y cumplir con normativa local sobre confidencialidad y retención documental.
- La precisión del OCR en documentos manuscritos o con formatos complejos es limitada, por lo que siempre requiere validación antes de decidir sobre decisiones clínicas o tratamientos.
- NexoLab ofrece un espacio privado para cada profesional, donde se almacenan los documentos digitalizados junto a su texto extraído, facilitando búsquedas rápidas y garantizando protección de datos.
Tabla de contenidos
- Qué metadatos necesita cada documento médico digitalizado
- Cómo implementar la extracción de texto paso a paso
- Seguridad, privacidad y cumplimiento normativo
- Usar el texto extraído sin delegar la decisión clínica en la máquina
- Por qué la gobernanza debe ir antes que la automatización
- Empezar a organizar los documentos de tu consultorio
- Fuentes
- Preguntas frecuentes
Qué metadatos necesita cada documento médico digitalizado
Un PDF médico sin metadatos es solo un archivo suelto. Para que la extracción de texto tenga valor clínico y quede protegida legalmente, cada documento debe registrarse con datos que permitan identificarlo, ubicarlo y auditarlo en cualquier momento.
Los campos mínimos que todo sistema de gestión debería exigir antes de aceptar un PDF son:
- Identificación del paciente: nombre y número único que evite confundir historiales entre personas con datos similares.
- Tipo de documento: receta, informe de laboratorio, epicrisis, imagen diagnóstica u otro clasificador que permita filtrar búsquedas.
- Fecha del documento y fecha de digitalización: ambas por separado, porque un informe firmado en una fecha puede escanearse semanas después.
- Autor u origen: el profesional o institución que generó el documento original, distinto de quien lo digitalizó.
- Encuentro clínico asociado: la consulta o episodio al que pertenece el archivo, para no dejarlo huérfano en el expediente.
Esta estructura no es una ocurrencia local: coincide con lo que exige el modelo DocumentReference de FHIR, que define cómo indexar y descubrir documentos clínicos, incluidos PDFs y escaneos, especificando metadata de sujeto, tipo, autor y contenido. Un sistema de gestión de pacientes que sigue este patrón evita duplicados mediante un índice maestro de pacientes y mantiene siempre el archivo fuente disponible junto al texto extraído, nunca como reemplazo.
Cómo implementar la extracción de texto paso a paso
Poner en marcha el OCR dentro de un consultorio no requiere un proyecto de meses, pero sí un flujo ordenado que evite que los documentos queden sueltos o mal indexados. Este es el recorrido que suele funcionar mejor en la práctica:
- Recepción y clasificación: al subir el PDF, se asigna de inmediato el paciente correspondiente y se completan los metadatos obligatorios antes de procesar nada.
- Conservación del original y ejecución del OCR: el archivo se guarda intacto y se lanza el reconocimiento de texto, ya sea en un servidor local o en la nube, según el volumen de documentos y las políticas de privacidad del consultorio.
- Presentación como borrador y revisión humana: el texto extraído se muestra como una versión provisional, nunca definitiva, y queda registrado quién la revisó y en qué momento.
- Indexación y vínculo al original: una vez confirmado, el texto se guarda como versión final, se indexa por los campos clave y cada resultado de búsqueda permite abrir el PDF original con un clic.
La guía HL7 sobre captura de documentos clínicos externos recomienda precisamente este patrón: etiquetar por tipo y fecha, y usar el OCR como mecanismo de captura mientras el documento original permanece intacto.
En consultorios con volumen alto conviene definir un plazo interno para revisar los borradores, por ejemplo antes de la siguiente cita del paciente, y establecer cuándo un documento debe volver a escanearse en vez de forzar una corrección manual extensa.
Consejo profesional: si un documento llega torcido o con baja resolución, es más rápido volver a escanearlo que corregir línea por línea un texto mal reconocido.
Seguridad, privacidad y cumplimiento normativo
Digitalizar documentos médicos sin controles técnicos convierte un archivo confidencial en un riesgo de filtración. Los elementos que no deberían faltar en ningún sistema son:
- Cifrado de archivos tanto en tránsito como en reposo.
- Control de acceso por rol, de forma que cada profesional solo vea los expedientes que le corresponden.
- Registro de auditoría que capture quién accedió, modificó o revisó cada documento y cuándo.
- Políticas de retención claras sobre cuánto tiempo se conservan los originales y sus copias digitalizadas.
En el ámbito ecuatoriano, el reglamento del MSP sobre información confidencial en el Sistema Nacional de Salud define las historias clínicas como confidenciales y exige gestión documental con archivo adecuado y trazabilidad demostrable. Cualquier flujo automatizado debe poder exportar sus registros de auditoría y entregar copias certificadas cuando la normativa lo requiera.
La confidencialidad no es opcional: la OMS recomienda evaluar riesgos de ciberseguridad antes de digitalizar historiales, incluyendo monitoreo de accesos y protocolos de notificación de brechas. Esa evaluación previa evita que un sistema mal configurado exponga datos sensibles desde el primer día.
Antes de contratar un proveedor externo de OCR o almacenamiento, conviene revisar sus políticas de tratamiento de datos y, cuando sea posible, anonimizar los documentos usados con fines de investigación o auditoría interna.
Usar el texto extraído sin delegar la decisión clínica en la máquina
El texto extraído sirve para encontrar información rápido, no para tomar decisiones clínicas sin revisión. Entre los usos más prácticos están las búsquedas por diagnóstico dentro del historial completo, la detección de medicación previa antes de prescribir algo nuevo y la revisión de antecedentes al preparar una consulta.
El OCR tiene límites conocidos: manuscritos, tablas complejas y formatos mixtos siguen generando errores. Un estudio en PLOS One mostró que un sistema OCR diseñado para registrar signos vitales y prescripciones redujo el tiempo de anotar medicamentos considerablemente y cometió menos errores que la entrada manual en el entorno probado, pero esa ganancia depende de que alguien valide números, unidades y nombres de medicamentos antes de confiar en ellos.
Algunos indicadores útiles para vigilar la calidad del proceso:
- Tasa de corrección: porcentaje de documentos donde el revisor tuvo que modificar el texto extraído.
- Tiempo medio de revisión por documento, para detectar cuellos de botella.
- Porcentaje de documentos problemáticos, como manuscritos o escaneos de baja calidad que requieren reproceso.
En la práctica, la interfaz debería mostrar el texto indexado junto a un botón de confirmar o editar, con el PDF original siempre accesible a un clic de distancia.
Por qué la gobernanza debe ir antes que la automatización

El error más común no es elegir un mal motor de OCR, sino automatizar sin haber definido antes quién accede a qué y con qué trazabilidad. Un pilotaje clínico publicado en Applied Clinical Informatics mostró que un pipeline de OCR combinado con procesamiento de lenguaje detectó la mayoría de los factores de riesgo hallados por revisión clínica manual en documentos escaneados, pero no los sustituyó: la validación humana siguió siendo necesaria en los casos límite.
Sin reglas claras de acceso y retención, digitalizar solo traslada al entorno digital los mismos desórdenes que existían en papel, ahora con capacidad de propagarse más rápido. Los espacios privados por profesional, donde los datos de cada médico no se mezclan con los de otros, reducen ese riesgo estructural desde el diseño mismo del sistema. Antes de escalar cualquier flujo de OCR conviene correr un piloto acotado, con métricas de corrección y tiempos de revisión definidas de antemano.
— MadScientist
Empezar a organizar los documentos de tu consultorio
NexoLab permite crear un espacio privado por cada médico, donde los PDFs, recetas y resultados de laboratorio se almacenan junto al texto que el OCR integrado extrae de cada documento, sin que los datos se mezclen entre distintos profesionales.
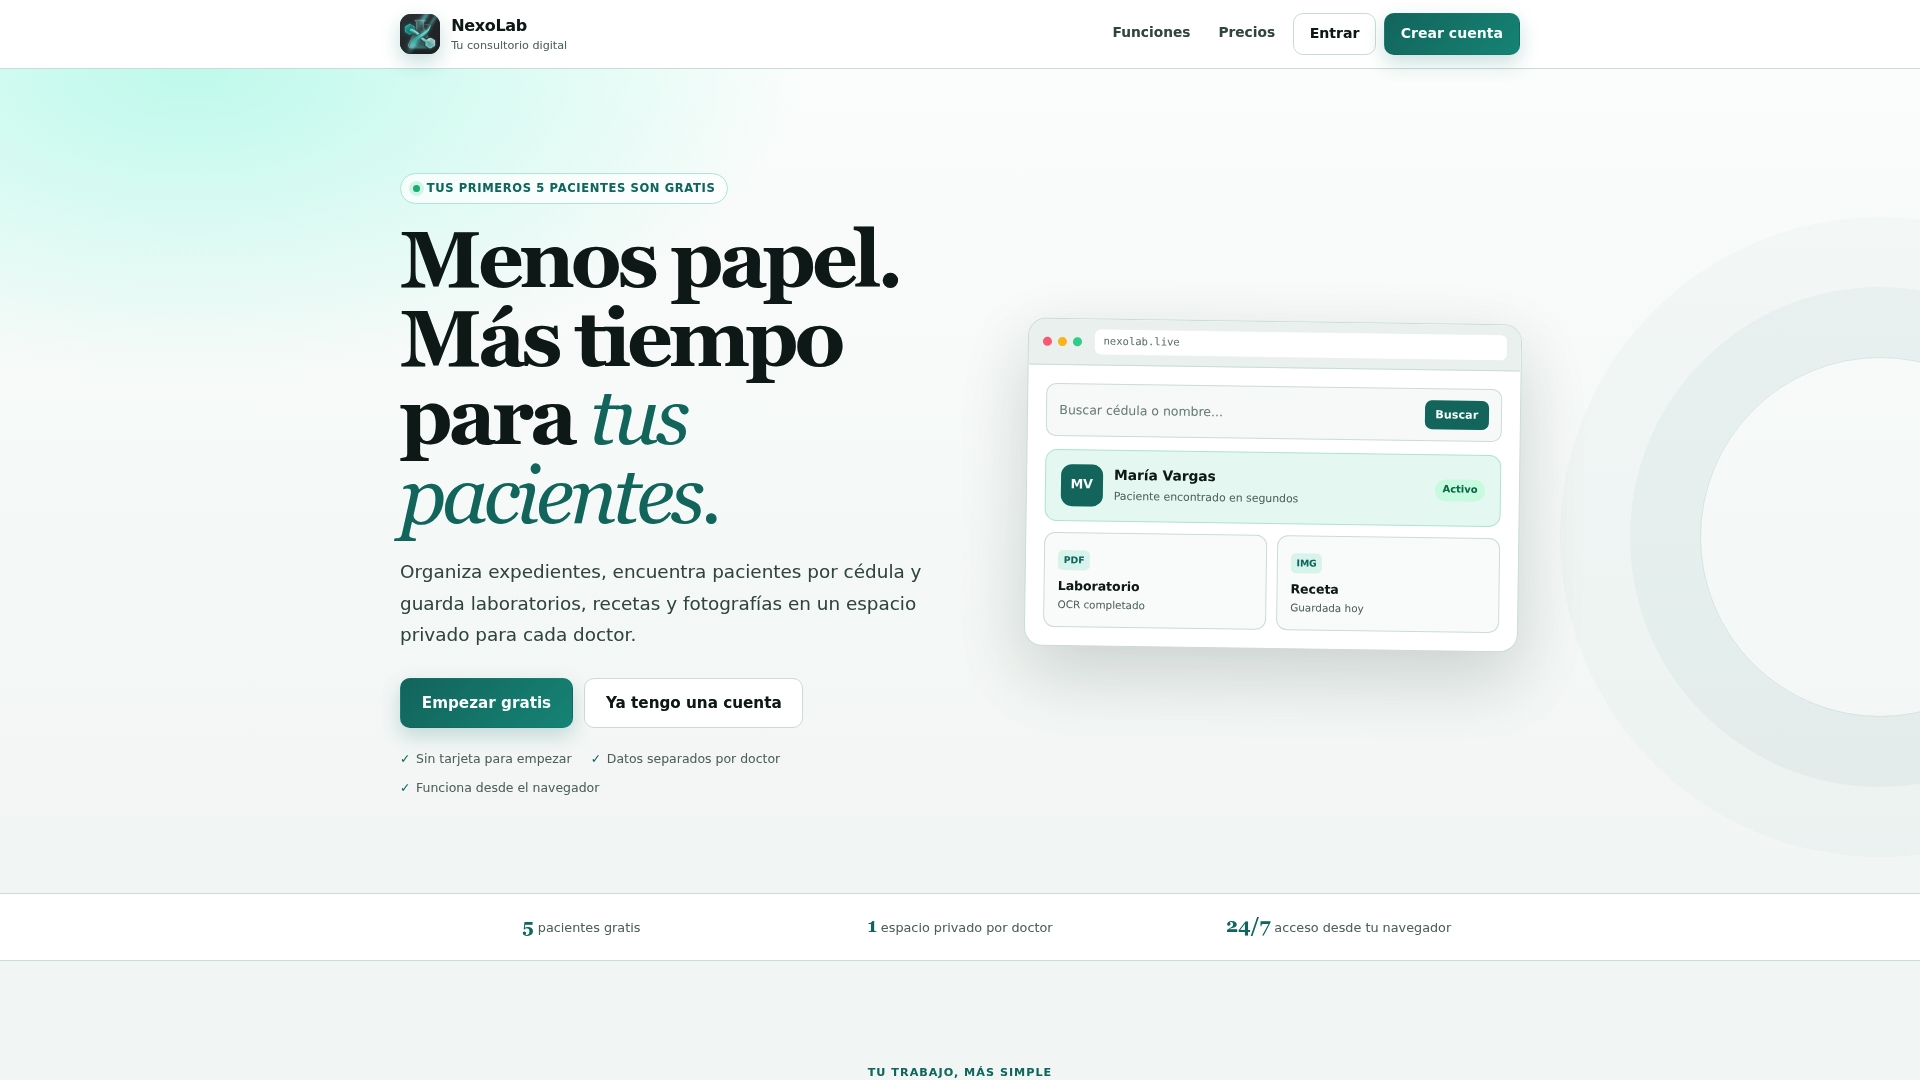
El registro es gratuito hasta cinco pacientes; los consultorios con más volumen pueden optar por planes de suscripción para manejar pacientes ilimitados. Si estás evaluando si conviene digitalizar tus expedientes con OCR integrado, revisa durante la prueba estos puntos:
- Calidad del texto reconocido en tus propios documentos, no en ejemplos genéricos.
- Control de accesos entre profesionales si trabajas en un consultorio compartido.
- Trazabilidad de revisiones: quién confirmó cada texto extraído y cuándo.
- Velocidad de búsqueda al escribir un nombre, una cédula o un diagnóstico.
Puedes crear tu cuenta gratuita y probar el OCR con tus propios documentos en Nexolab.
Fuentes
- CPS.2.1 Support externally-sourced Clinical Documents - HL7 Electronic Health Record System Functional Model, Release 2.1.1 v2.1.1-ballot
- Reglamento de información confidencial en Sistema Nacional de Salud (MSP)
- Development of novel OCR system to reduce recording time for vital signs and prescriptions (PLOS One)
- Pilot study: OCR + NLP to identify risk factors in scanned EHR documents (Applied Clinical Informatics)
Preguntas frecuentes
¿El texto extraído reemplaza el PDF original del paciente?
No, el PDF original debe conservarse siempre como documento legal y fuente de verdad. El texto extraído es un índice de búsqueda que facilita encontrar información, pero cualquier resultado debe permitir abrir el archivo fuente con un clic.
¿Qué tan confiable es el OCR en documentos médicos manuscritos?
El OCR funciona mejor en texto impreso que en manuscritos, tablas complejas o formatos mixtos, donde los errores son más frecuentes. Por eso la revisión humana de números, unidades y nombres de medicamentos sigue siendo necesaria antes de confiar en el texto extraído para decisiones clínicas.
¿Qué metadatos debe registrar un consultorio al digitalizar un documento?
Como mínimo, el paciente, el tipo de documento, la fecha del documento y de su digitalización, el autor u origen y el encuentro clínico asociado. Este patrón coincide con el modelo DocumentReference de FHIR, pensado justamente para indexar documentos como PDFs y escaneos.
¿NexoLab permite extraer texto de PDFs médicos dentro del expediente?
Sí, NexoLab integra OCR para leer documentos y almacenarlos junto al texto extraído dentro de la ficha privada de cada paciente. Cada médico cuenta con un espacio propio donde sus documentos no se mezclan con los de otros profesionales.
¿Cómo se protege la confidencialidad al digitalizar historias clínicas?
Mediante cifrado, control de acceso por rol y registros de auditoría que documenten quién accedió o modificó cada archivo. En el ámbito local, el reglamento del MSP exige además trazabilidad documental demostrable para todo historial clínico digitalizado.