
Anonimización vs seudonimización: la diferencia legal que decide si el RGPD te aplica
La anonimización es un proceso irreversible: si se demuestra que la reidentificación es objetivamente improbable, los datos dejan de ser personales y salen del ámbito del RGPD. La seudonimización, en cambio, es reversible mediante «información adicional» custodiada por separado, así que los datos siguen siendo personales y exigen las mismas salvaguardas que cualquier otro dato sensible.
En resumen:
- La anonimización es irreversible y excluye los datos del RGPD solo si se demuestra que la reidentificación es objetivamente improbable mediante técnicas combinadas.
- La seudonimización es reversible y requiere protección estricta de la información adicional para evitar su vinculación con la identidad del interesado.
- La elección entre ambas técnicas depende del uso previsto: anonimizar si el dato se publicará y se volverá irreversible, o seudonimizar para análisis internos con posibilidad de revertir.
- Evaluar el riesgo de reidentificación implica considerar ataques de singularización, vinculación e inferencia, actualizando estos análisis ante avances tecnológicos.
- Es fundamental proteger rigurosamente la información adicional en la seudonimización mediante controles de acceso, separación de funciones y auditorías periódicas.
Tabla de contenidos
- Qué es la anonimización: definición, técnicas y cuándo se considera efectiva
- Qué es la seudonimización según el Art. 4(5) del RGPD
- Anonimización vs seudonimización: diferencias que cambian tus obligaciones
- Anonimización y seudonimización en datos sanitarios: dos casos reales
- Cómo evaluar el riesgo de reidentificación
- Cómo proteger la información adicional que sostiene la seudonimización
- Cuándo elegir cada enfoque y cuándo se necesita una EIPD
- Perspectiva editorial: lo que falla en la práctica clínica
- Cómo Nexolab ayuda a custodiar la información adicional en tu consultorio
- Fuentes
- Preguntas frecuentes
Qué es la anonimización: definición, técnicas y cuándo se considera efectiva
La anonimización no es un simple borrado de nombres. El Considerando 26 del RGPD exige que la identificación sea objetivamente improbable, considerando todos los medios «razonablemente probables» según coste, tiempo y tecnología disponible. Las guías del EDPB precisan que una anonimización robusta rara vez se logra con una sola técnica: hace falta combinarlas.
Las técnicas más usadas en la práctica son:
- K-anonimato: agrupa registros para que cada combinación de atributos aparezca al menos k veces, evitando que un individuo se distinga del resto.
- L-diversity: refuerza el k-anonimato asegurando variedad de valores sensibles dentro de cada grupo.
- Privacidad diferencial: introduce ruido matemático controlado en los resultados agregados sin alterar las conclusiones estadísticas.
- Agregación y perturbación: sustituyen valores exactos por rangos o los modifican ligeramente para romper la trazabilidad individual.
El problema real suele estar en los cuasi-identificadores: una combinación de edad, código postal y fecha de una consulta médica puede reidentificar a alguien aunque el nombre haya desaparecido. Por eso las guías del EDPB sobre anonimización insisten en documentar el método, las pruebas de robustez aplicadas y la pérdida de utilidad aceptada a cambio de la protección.
Qué es la seudonimización según el Art. 4(5) del RGPD
El artículo 4(5) del RGPD define la seudonimización como el tratamiento de datos personales de forma que ya no puedan atribuirse a un interesado sin recurrir a información adicional, siempre que esa información se mantenga separada y protegida con medidas técnicas y organizativas. La clave está en el condicional: «sin información adicional». Esa información existe, y mientras exista, el dato sigue siendo personal.
Las técnicas habituales para generar pseudónimos incluyen:
- Hashing con sal: aplica una función criptográfica más un valor aleatorio único para evitar ataques de diccionario contra el identificador original.
- Tokenización: sustituye el dato real por un token sin relación matemática directa, gestionado en una tabla de correspondencia externa.
- Cifrado con gestión de claves: transforma el dato de forma reversible únicamente para quien posea la clave correspondiente.
La diferencia entre métodos reversibles e irreversibles importa mucho: un hash sin sal puede romperse por fuerza bruta, mientras que un token bien gestionado exige acceso físico a la tabla de correspondencia. En ambos casos, el dato seudonimizado sigue bajo el RGPD y exige base legal, información al interesado y medidas de seguridad proporcionales al riesgo.
Anonimización vs seudonimización: diferencias que cambian tus obligaciones
Antes de elegir un método conviene tener clara la consecuencia legal de cada camino, porque no se trata solo de técnica sino de qué reglas te siguen aplicando después.
- Alcance normativo: los datos anonimizados quedan fuera del RGPD si se demuestra objetivamente la imposibilidad de reidentificación; los datos seudonimizados permanecen dentro, junto con la información adicional que los vincula.
- Reversibilidad: la anonimización busca ser permanente; la seudonimización se diseña para poder revertirse bajo control, normalmente por motivos operativos o clínicos.
- Conservación y transferencias: un dataset verdaderamente anónimo puede conservarse indefinidamente y transferirse sin las cláusulas propias de datos personales; uno seudonimizado sigue sujeto a plazos de conservación y a acuerdos de tratamiento con terceros.
- Derechos de los interesados: sobre datos anonimizados no se pueden ejercer derechos de acceso o rectificación porque ya no identifican a nadie; sobre datos seudonimizados, esos derechos siguen vigentes.
- Evidencia requerida: anonimizar exige un informe de riesgo documentado y reproducible; seudonimizar exige, sobre todo, controles de acceso y trazabilidad sobre quién puede revertir el proceso.
Anonimización y seudonimización en datos sanitarios: dos casos reales
Un equipo que prepara un dataset para un estudio epidemiológico público necesita anonimización real, no seudonimización. Aquí funciona combinar agregación de variables clínicas con privacidad diferencial en los cálculos estadísticos finales, de modo que las cifras publicadas mantengan valor científico sin permitir reconstruir historiales individuales.
Un equipo que analiza reingresos hospitalarios para mejorar procesos internos necesita seudonimización, porque en algún momento puede requerir volver al paciente concreto (por ejemplo, ante una alerta de seguridad clínica). Aquí conviene:
- Sustituir el identificador del paciente por un token en el dataset de trabajo.
- Guardar la tabla de correspondencia en un sistema distinto, con acceso restringido por rol.
- Limitar quién puede solicitar la reversión y registrar cada solicitud.
Consejo profesional: documenta desde el diseño del proyecto qué variables son cuasi-identificadores potenciales (fecha de nacimiento exacta, código postal, diagnóstico raro). Generalizarlas desde el inicio evita rehacer todo el proceso de anonimización cuando alguien detecta que un pequeño grupo de pacientes es identificable por combinación de atributos.
Cómo evaluar el riesgo de reidentificación
El Considerando 26 obliga a valorar «todos los medios razonablemente probables», no solo los técnicamente posibles. Eso significa sopesar coste, tiempo y estado de la tecnología disponible en el momento del análisis, no en un escenario hipotético e ilimitado.
Los evaluadores suelen distinguir tres tipos de ataque:
- Singularización: aislar un registro que corresponde a un individuo concreto dentro del conjunto.
- Vinculación: cruzar el dataset con otra fuente externa para relacionar dos registros con la misma persona.
- Inferencia: deducir un atributo sensible con alta probabilidad a partir de otros datos disponibles, sin necesidad de vincular registros exactos.
La evolución de la inteligencia artificial y la disponibilidad creciente de datos públicos obligan a reevaluar periódicamente lo que hoy parece anónimo. Un dataset «seguro» en 2023 puede dejar de serlo si aparecen nuevas fuentes de cruce.
Cómo proteger la información adicional que sostiene la seudonimización
La seudonimización solo funciona como salvaguarda real si la información adicional está tan protegida como el dato original. Estas son las medidas que marcan la diferencia:
- Separación de funciones: quien opera con el dataset seudonimizado no debe tener acceso directo a la tabla de correspondencia.
- Control de accesos por rol y autenticación reforzada: limita quién puede solicitar una reversión y bajo qué circunstancia.
- Cifrado de claves y rotación periódica: reduce la ventana de exposición si una clave se compromete.
- Registros de auditoría: cada consulta a la tabla de correspondencia debe quedar trazada, con fecha, usuario y motivo.
- Cláusulas contractuales con procesadores externos: cualquier tercero que trate datos seudonimizados necesita obligaciones equivalentes a las del responsable.
Consejo profesional: aplica pruebas periódicas de reversión controlada usando datos ficticios, no reales, para verificar que el proceso funciona sin exponer información de pacientes durante la auditoría.
Cuándo elegir cada enfoque y cuándo se necesita una EIPD
La regla práctica es sencilla: anonimiza cuando el dato va a difundirse, publicarse o usarse en estudios donde nadie necesitará volver al individuo. Seudonimiza cuando el análisis es interno y podrías necesitar revertir el proceso, por ejemplo en seguimiento clínico o auditorías de calidad.
Una Evaluación de Impacto de Protección de Datos (EIPD) se vuelve obligatoria cuando se tratan datos de salud a gran escala o de forma sistemática, según el propio RGPD y las orientaciones de la AEPD. La documentación de cualquier proceso de anonimización debe incluir la metodología aplicada, las pruebas de robustez frente a reidentificación y un plan de reevaluación periódica, no solo la descripción técnica del algoritmo usado.

Perspectiva editorial: lo que falla en la práctica clínica
El error más frecuente en consultorios y hospitales es tratar la seudonimización como si fuera anonimización: sustituir el nombre por un código y asumir que el problema legal desapareció. No es así, y esa confusión genera brechas reales de cumplimiento.
Lo que funciona es combinar técnicas según el destino del dato y documentar cada decisión, no solo el resultado. También hace falta formación cruzada: el equipo clínico entiende el dato, legal entiende el riesgo normativo, y TI entiende dónde vive realmente la información adicional. Sin esa conversación, cualquier salvaguarda técnica queda coja.
— MadScientist
Cómo Nexolab ayuda a custodiar la información adicional en tu consultorio
Nexolab es una alternativa práctica frente a hojas de cálculo compartidas o carpetas comunes para gestionar la seudonimización en el día a día clínico: cada médico trabaja en un espacio 100 % privado donde los datos no se mezclan entre profesionales, lo que refuerza justo la separación de funciones que exige custodiar bien la información adicional.
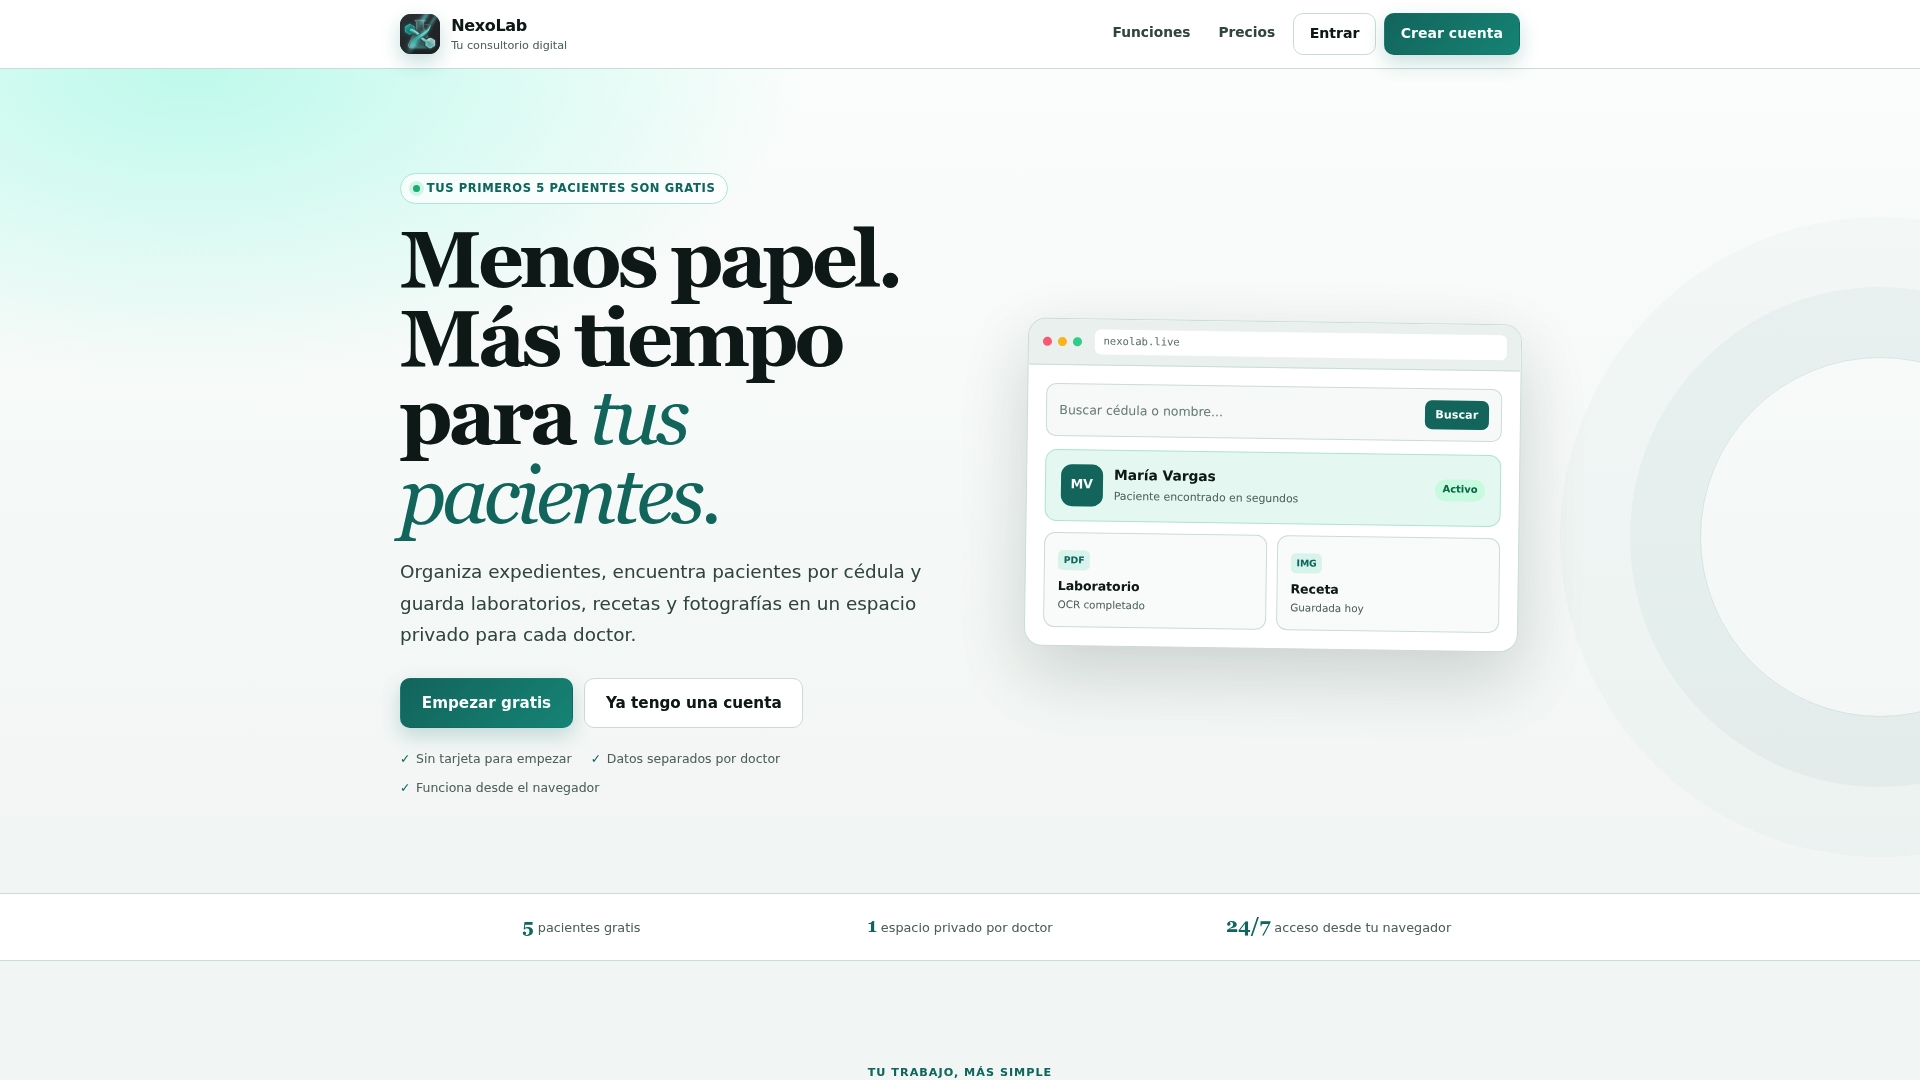
La plataforma incluye almacenamiento de archivos (PDFs, fotos, recetas, informes de laboratorio), lectura por OCR para extraer texto de documentos médicos y un directorio de búsqueda por nombre o cédula que permite mantener el historial clínico organizado sin exponerlo entre distintos doctores. Combinar esto con autenticación de dos factores reduce el riesgo de accesos no autorizados a las tablas de correspondencia que sostienen cualquier proceso de seudonimización.
Puedes empezar gratis con hasta 5 pacientes en el plan Free, o pasar al plan Pro mensual por 49.99 $ al mes o al Pro anual por 499.88 $ al año para gestionar pacientes ilimitados. Prueba la plataforma en Nexolab y evalúa si se ajusta a los controles de acceso que necesita tu consultorio.

Fuentes
Estas son las referencias que sostienen la interpretación legal y técnica de este artículo:
Preguntas frecuentes
¿Qué es la seudonimización?
Es el tratamiento de datos personales de forma que no puedan atribuirse a un interesado sin información adicional, según el Art. 4(5) del RGPD. Esa información adicional debe guardarse separada y protegida, y el dato sigue considerándose personal en todo momento.
¿Qué es la anonimización?
Es el proceso que elimina la posibilidad de vincular un dato con una persona identificable, de forma objetivamente irreversible según el Considerando 26 del RGPD. Cuando se demuestra esa irreversibilidad, el dato deja de estar sujeto al reglamento.
¿En qué consiste el proceso de anonimización?
Consiste en aplicar técnicas como generalización, agregación, k-anonimato o privacidad diferencial, y luego evaluar si sigue existiendo algún medio razonablemente probable de reidentificación. Las guías del EDPB recomiendan documentar la metodología y repetir esta evaluación con el tiempo, porque la tecnología disponible cambia.
¿Cuáles son los tipos principales de datos personales en este contexto?
En protección de datos suele distinguirse entre datos identificativos directos (nombre, cédula), datos seudonimizados (protegidos por un token o hash reversible) y datos anonimizados (sin ninguna vía razonable de reidentificación). Solo los dos primeros tipos permanecen bajo el ámbito del RGPD.
¿Nexolab ofrece herramientas para gestionar la seudonimización?
Nexolab no sustituye el análisis legal, pero sus espacios privados por médico, el cifrado de almacenamiento y el control de accesos ayudan a custodiar la información adicional que exige la seudonimización. El plan gratuito permite probar estas funciones con hasta 5 pacientes antes de pasar a un plan de pago disponible en Nexolab.